データ分析実践
上級問題チェック
問題 31 /40
日経平均の終値をグラフにした次の記述に関して、誤った説明はどれか。
import pandas as pd
import plotly.express as px
df = pd.read_csv(
'nikkei_stock_average_daily_jp.csv',
encoding='cp932',
parse_dates=['データ日付'],
date_format='%Y/%m/%d',
usecols=[0, 1],
index_col=0,
skipfooter=1)
df['移動平均7日'] = df['終値'].rolling(window=7, min_periods=1).mean()
df['移動平均30日'] = df['終値'].rolling(window=30, min_periods=1).mean()
px.line(df['2024-08-01':'2024-08-31'])
選択 1
read_csvメソッドで、ローカルのCSVファイルを取得している。
選択 2
rollingメソッドで、現在のデータ点を中心として前後7日間と前後30日間の平均値を算出している。
選択 3
rollingメソッドのmin_periods引数で、データがNaNにならないようにしている。
選択 4
Plotly Expressのline関数で、特定の期間のデータを折れ線グラフにしている。
解説
選択肢2が正解です。
import pandas as pd
import plotly.express as px
df = pd.read_csv(
'nikkei_stock_average_daily_jp.csv',
encoding='cp932',
parse_dates=['データ日付'],
date_format='%Y/%m/%d',
usecols=[0, 1],
index_col=0,
skipfooter=1)
df['移動平均7日'] = df['終値'].rolling(window=7, min_periods=1).mean()
df['移動平均30日'] = df['終値'].rolling(window=30, min_periods=1).mean()
px.line(df['2024-08-01':'2024-08-31'])
▶︎
 【選択肢1】
read_csvメソッドで、ローカルのCSVファイルを取得している。
正しい説明です。
日経平均のデータは次のサイトでダウンロードできます。
https://indexes.nikkei.co.jp/nkave/index?type=download
read_csvメソッドはインターネット上のデータを取得できるため、通常は次の記述で取得できますが、日経平均のサイトはエラーになります。
df = pd.read_csv('https://indexes.nikkei.co.jp/nkave/historical/nikkei_stock_average_daily_jp.csv', encoding='cp932')
▶︎
HTTPError: HTTP Error 403: Forbidden
ブラウザ以外のアクセスが拒否されているためエラーになります。回避方法としては、requestsモジュールでheaders引数をつけて取得するか、ブラウザで手動でダウンロードしてファイルをローカルに保存します。
df = pd.read_csv(
'nikkei_stock_average_daily_jp.csv',
encoding='cp932',
parse_dates=['データ日付'],
date_format='%Y/%m/%d',
usecols=[0, 1],
index_col=0,
skipfooter=1)
▶︎
 【選択肢2】
rollingメソッドで、現在のデータ点を中心として前後7日間と前後30日間の平均値を算出している。
誤った説明です。
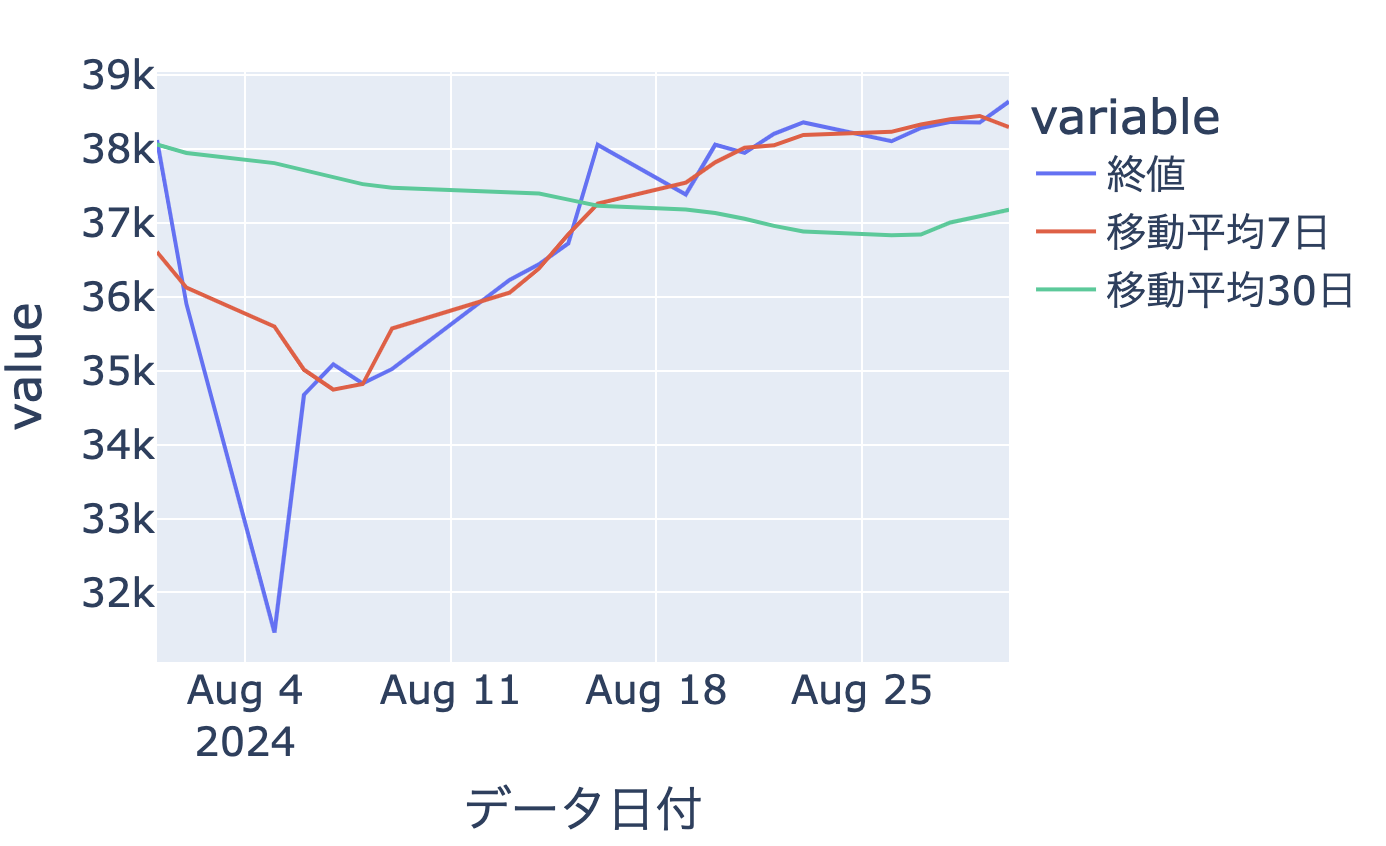
rollingメソッドは、デフォルトで「Center=False」の引数になり、現在のデータ点とその前のデータ点を対象とします。例えば、8月7日が現在のデータ点で7日間の移動平均の場合、8月1日〜8月7日のデータで平均を算出します。
「Center=True」の引数をつけると、現在のデータ点を中心として前後のデータ点を対象とします。例えば、8月7日が現在のデータ点で7日間の移動平均の場合、8月4日〜8月10日のデータで平均を算出します。
問題文の場合は引数がないので「Center=False」です。これを「Center=True」にすると、このグラフの場合は特に移動平均7日間の見え方が変わります。
Center=False
▶︎
Center=True
▶︎
 【選択肢3】
rollingメソッドのmin_periods引数で、データがNaNにならないようにしている。
正しい説明です。
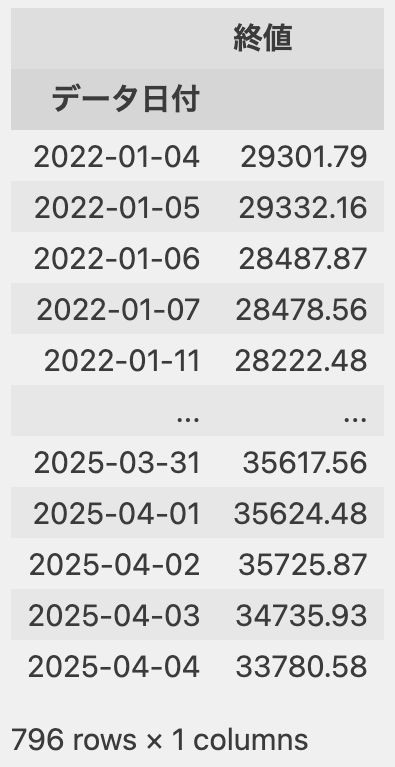
rollingメソッドは、デフォルトで現在のデータ点とその前のデータ点を対象とします。そのため、データの最初のほうはその前のデータが存在しないため、NaNになります。
df['移動平均7日'] = df['終値'].rolling(window=7).mean()
df['移動平均30日'] = df['終値'].rolling(window=30).mean()
df
▶︎
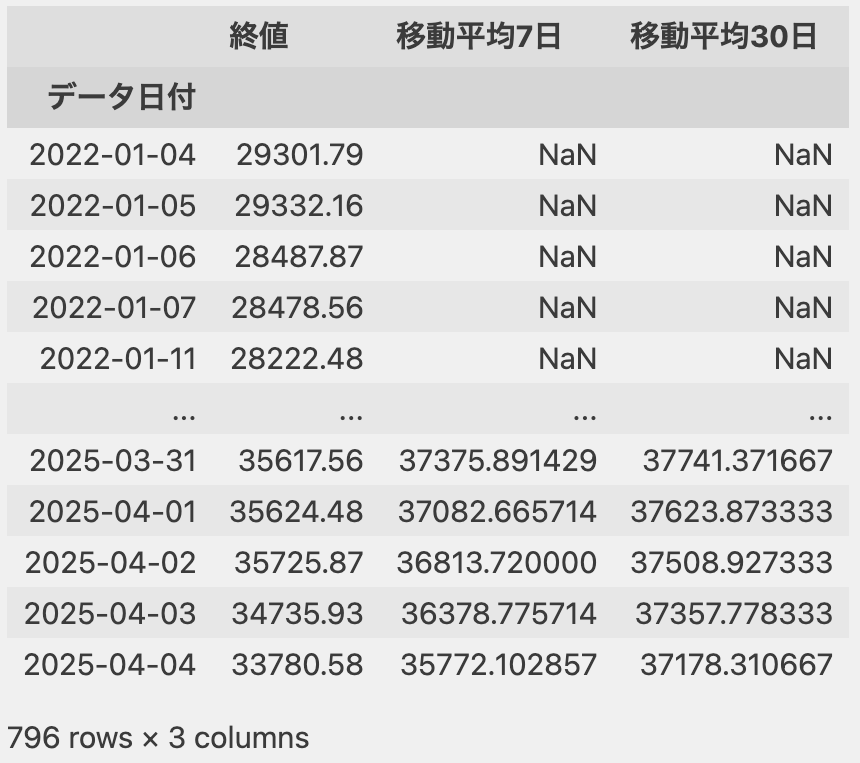 「min_periods=1」の引数をつけると、データが1個でもあれば計算するため、NaNがなくなります。
df['移動平均7日'] = df['終値'].rolling(window=7, min_periods=1).mean()
df['移動平均30日'] = df['終値'].rolling(window=30, min_periods=1).mean()
df
▶︎
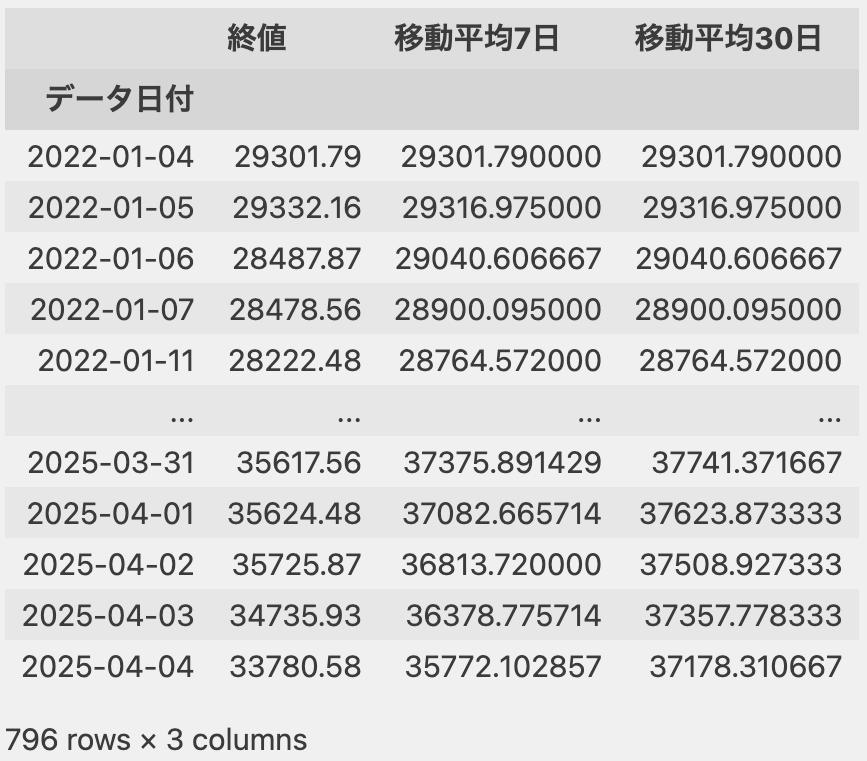 2022年1月4日は1日だけで平均を算出しており、2022年1月5日は1月4日と1月5日の2日で平均を算出しています。
【選択肢4】
Plotly Expressのline関数で、特定の期間のデータを折れ線グラフにしている。
正しい説明です。
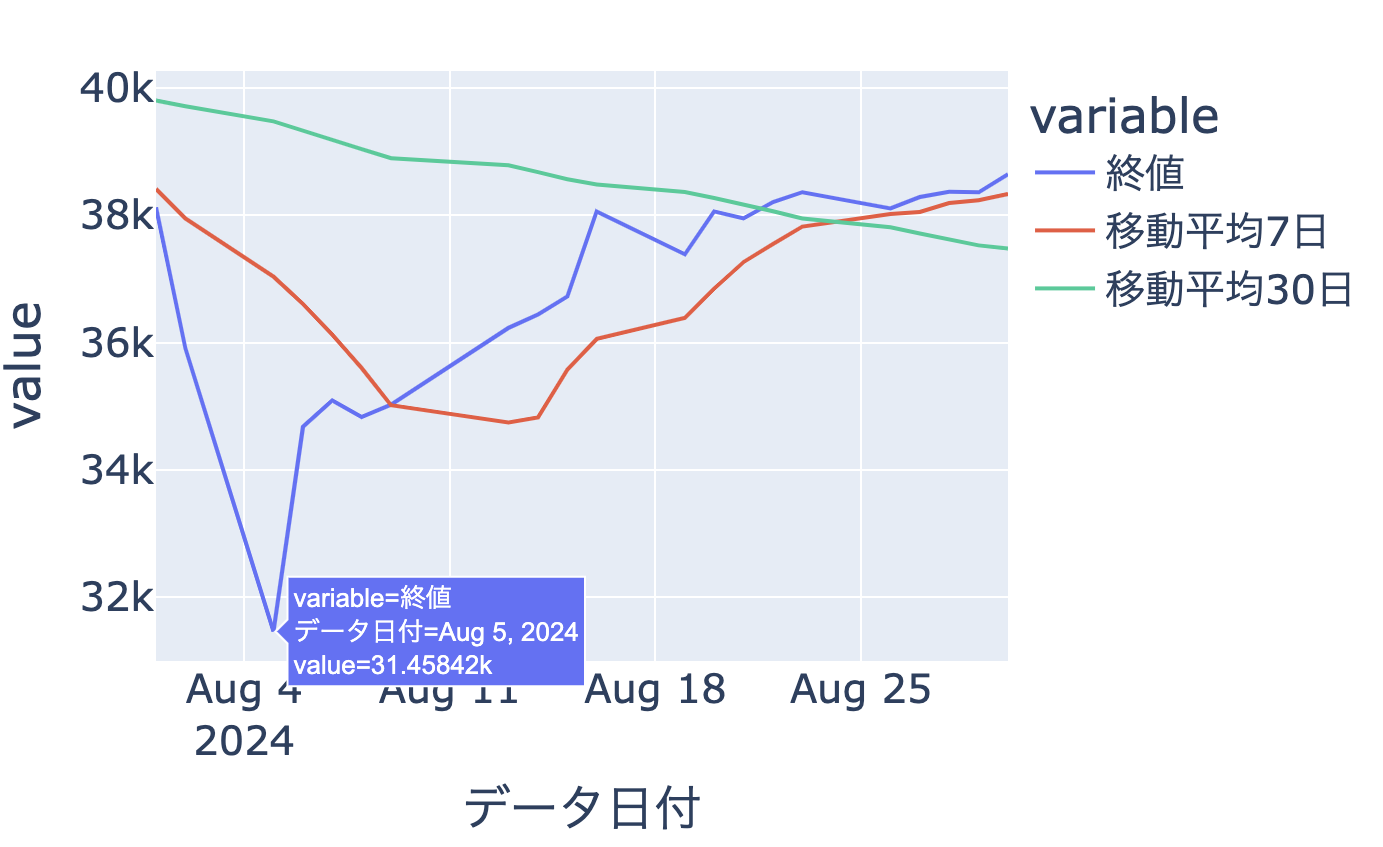
DataFrameの期間は2022年1月4日〜2025年4月4日ですが、df['2024-08-01':'2024-08-31']により、2024年8月1日〜2024年8月31日のデータを対象にしています。
px.line(df['2024-08-01':'2024-08-31'])
▶︎
移動平均は、変化の激しいデータの傾向を把握しやすくなります。このグラフの場合、終値でリアルタイムの値、移動平均7日で短期の傾向、移動平均30日で長期の傾向を把握します。終値を見ると変化が激しいですが、長期で見ると緩やかな下降であることが分かります。
Plotlyはグラフにマウスオーバーすると値を確認できます。2024年8月5日の大暴落は何があったのでしょう。
【選択肢2】
rollingメソッドで、現在のデータ点を中心として前後7日間と前後30日間の平均値を算出している。
誤った説明です。
rollingメソッドは、デフォルトで「Center=False」の引数になり、現在のデータ点とその前のデータ点を対象とします。例えば、8月7日が現在のデータ点で7日間の移動平均の場合、8月1日〜8月7日のデータで平均を算出します。
「Center=True」の引数をつけると、現在のデータ点を中心として前後のデータ点を対象とします。例えば、8月7日が現在のデータ点で7日間の移動平均の場合、8月4日〜8月10日のデータで平均を算出します。
問題文の場合は引数がないので「Center=False」です。これを「Center=True」にすると、このグラフの場合は特に移動平均7日間の見え方が変わります。
Center=False
▶︎