データ分析・中級問題チェック
問題 38 /40
機械学習の過学習に関する説明で、正しいものはどれか。
選択 1
過学習になる場合は、特徴量を減らしたり、アルゴリズムを変える。
選択 2
訓練データもテストデータも正解率が低いと、過学習と言える。
選択 3
訓練データの正解率が高く、テストデータの正解率が低い場合は、適合不足と言える。
選択 4
訓練データの正解率が高ければ、汎化性能が良いと言える。
解説
選択肢1が正解です。
機械学習の目的は汎化性能を上げることです。訓練データで学習モデルを作り、そのモデルがテストデータや未知のデータに対して高い精度で予測できると、汎化性能が良いと言えます。
訓練データに適合しすぎると過学習の状態になり、汎化性能が悪くなります。
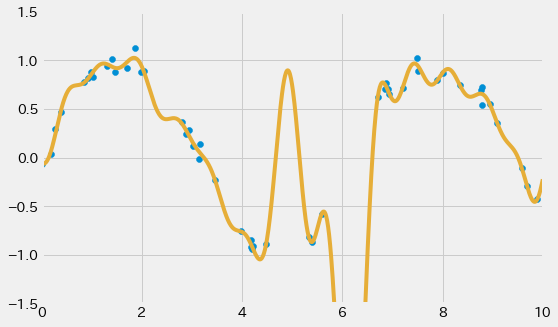
例えば、説明変数が100個あるデータに対して、訓練データの正解率が95%、テストデータの正解率が60%だと、過学習と言えます。次のグラフの黄色い線のように、訓練データに過剰に適合しすぎて、汎化性能が悪くなっています。
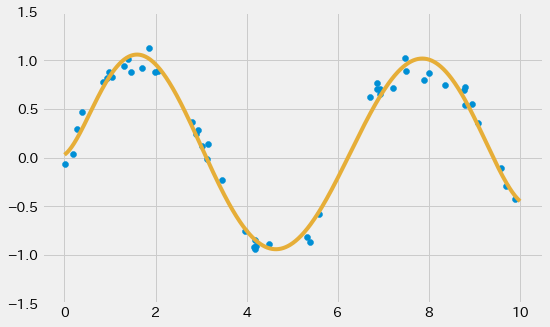
 この場合は主成分分析の次元削減で説明変数を減らしたり、他のアルゴリズムを採用して次のように適合させる必要があります。
 また、説明変数が極端に少ない場合など、モデルが単純すぎると適合不足になります。
例えば、説明変数が1つしかないデータに対して、訓練テストの正解率が60%、テストデータの正解率が60%だと適合不足と言えます。この場合は説明変数を2乗、3乗するなどして、説明変数を増やす必要があります。
【選択肢1】
過学習になる場合は、特徴量を減らしたり、アルゴリズムを変える。
正しい説明です。
【選択肢2】
訓練データもテストデータも正解率が低いと、過学習と言える。
誤った説明です。
訓練データの正解率が高く、テストデータの正解率が低いと、過学習と言えます。
【選択肢3】
訓練データの正解率が高く、テストデータの正解率が低い場合は、適合不足と言える。
誤った説明です。
訓練データもテストデータも正解率が低いと、適合不足と言えます。
【選択肢4】
訓練データの正解率が高ければ、汎化性能が良いと言える。
誤った説明です。
訓練データではなく、テストデータの正解率が高いと、汎化性能が良いと言えます。
なお、公式書籍に「過学習」という用語は登場しません。