日経平均のバックテスト
データ分析実践試験の問題31で、日経平均の終値から移動平均を計算し、グラフにする題材を扱いました。この移動平均は「テクニカル指標」と呼ばれるもののひとつで、株価や為替の分析に使われています。
テクニカル指標には移動平均のほかにも多くの種類があり、それらを使った売買手法も確立されています。さらに、過去のデータに対してその売買手法が通用したかを検証する「バックテスト」という方法もあります。
今回は、Pythonのpandasを使ってテクニカル指標を計算し、バックテストで売買結果を検証する方法を紹介します。データの可視化はPlotlyを使います。なお、同じようなバックテストや可視化はアプリでも試せます(8. スマホアプリで試す)。
この記事もアプリも、扱うのは過去のデータの計算だけで、実際の売買は行いません。
目次
1. 概要
今回は3つのテーマを扱います。
1つ目は、日経平均の終値からテクニカル指標を計算することです。移動平均、指数移動平均、RSI、MACDなどを取り上げます。いずれもpandasのメソッドを組み合わせるだけで計算できます。
2つ目は、定番の売買手法である「ゴールデンクロス」と「デッドクロス」をルールにして、過去のデータで検証することです。これがバックテストです。通常は日経平均に対して売買を行うことはありませんが、ここでは題材として利用します。
3つ目は、結果をグラフと数字で確認することです。どこで買ってどこで売ったのかをPlotlyのグラフに重ね、取引回数、勝率、総利益、最大ドローダウンを計算します。
Plotlyの関連問題
2. テクニカル指標
テクニカル指標とは、価格や出来高から計算する指標のことです。価格そのものを眺めるだけでは分かりにくい「方向」や「勢い」を数値にして、売買の判断に使います。
指標は数多くありますが、ここでは代表的なものをいくつか紹介します。
2-1. 移動平均(MA)
一定期間の終値を平均したものです。日々の上下をならして、価格がどちらを向いているかを見やすくします。期間が短いほど価格の近くを動き、長いほどなだらかになります。
ma25 = df['終値'].rolling(25).mean()
rollingは「窓」を移動させながら集計するpandasのメソッドです。25を指定すると、その日を含む直近25日が対象になります。
ここで注意したいのが、rollingの引数centerです。既定値はFalseで、その日とそれ以前のデータが対象になります。例えば、8月7日が現在のデータ点で7日間の移動平均の場合、8月1日〜8月7日のデータで平均を算出します。
「center=True」の引数をつけると、現在のデータ点を中心として前後のデータ点を対象とします。例えば、8月7日が現在のデータ点で7日間の移動平均の場合、8月4日〜8月10日のデータで平均を算出します。
「center=True」にすると前後のデータが対象になり、まだ起きていない値動きを含むことになります。売買の判断に使う以上、未来のデータを見ることはできません。そのため既定値のまま使います。
2-2. 指数移動平均(EMA)
移動平均は期間内のすべての日を同じ重みで扱いますが、指数移動平均は直近の日ほど重く扱います。そのぶん価格の変化に早く反応します。
ema25 = df['終値'].ewm(span=25, adjust=False).mean()
ewmはpandasのメソッドで、Exponentially Weighted Mean(指数加重平均)の略です。rollingが「窓の中を同じ重みで集計する」のに対し、ewmは「古いデータほど軽く扱いながら、すべてのデータを使って集計する」という違いがあります。rollingと同じように、呼び出したあとにmean()やstd()をつないで使います。
spanは期間にあたる引数です。25を指定すると、その日の終値が結果に占める割合は約7.7%で、残りの約92.3%は前日までの値を引き継ぎます。これが5なら当日ぶんが約33.3%に増え、値動きに敏感に反応するようになります。
adjust=Falseは、一般的なテクニカル指標の定義に合わせるための指定です。省略するとTrueになり、計算方法が変わって値がずれます。
2-3. RSI
一定期間の値動きのうち、上昇分がどれくらいの割合を占めるかを0〜100で表した指標です。30以下が売られすぎ、70以上が買われすぎの目安となっています。30以下になったら価格が上がることを見越して購入し、70以上になったら価格が下がることを見越して売却するという、逆張りと呼ばれる手法で使われます。
diff = df['終値'].diff()
up   = diff.clip(lower=0)
down = -diff.clip(upper=0)

avg_up   = up.ewm(alpha=1/14, adjust=False).mean()
avg_down = down.ewm(alpha=1/14, adjust=False).mean()

rsi = 100 - 100 / (1 + avg_up / avg_down)
diffは前の行との差を返すメソッドです。値上がりした日はプラス、値下がりした日はマイナスの値になります。終値が100、103、101、105、104と動いた場合は次のようになります。
| 終値 | diff |
|---|---|
| 100 | — |
| 103 | +3 |
| 101 | -2 |
| 105 | +4 |
| 104 | -1 |
1日目は前の日が無いため計算できず、空欄になります。
次にclipで、この差を値上がり分と値下がり分に分けます。clipは値の上限や下限を決めて、はみ出した分をその値に置き換えるメソッドです。
clip(lower=0)は下限を0にするので、マイナスの日がすべて0になり、upには値上がり幅だけが残ります。逆にclip(upper=0)は上限を0にして値下がりの日だけを残しますが、その値はマイナスのままです。そこで先頭にマイナスを付けて符号を反転させ、プラスの値に直しています。
| diff | up | down |
|---|---|---|
| — | — | — |
| +3 | 3 | 0 |
| -2 | 0 | 2 |
| +4 | 4 | 0 |
| -1 | 0 | 1 |
RSIは一定期間の値上がり幅と値下がり幅の平均を比べる指標なので、両方をプラスの値として用意する必要があります。
ここで使っているewmのalpha=1/14は「ワイルダーの平滑化」と呼ばれる方法です。単純平均で計算する流儀もあり、どちらを使うかで同じ「RSI(14)」でも値が変わります。テクニカル指標は、名前と期間が同じでも計算方法が複数ある場合があります。
2-4. MACD
期間の違う2本の指数移動平均の差です。2本が離れていくほど値が大きくなり、勢いの強さを表します。
ema12 = df['終値'].ewm(span=12, adjust=False).mean()
ema26 = df['終値'].ewm(span=26, adjust=False).mean()

macd   = ema12 - ema26
signal = macd.ewm(span=9, adjust=False).mean()
signalは、そのMACDをさらに平滑化したものです。ewmを呼んでいる対象が終値ではなくmacdである点に注目してください。ここでは指標から別の指標を作っています。
MACDとシグナルは、2本の線として一緒に使われます。MACDがシグナルを下から上に抜けたときを買いのタイミングとする使い方が一般的です。
12、26、9という数字は慣習的に使われている値です。他の指標と同じように、この期間は変更できます。
2-5. ボリンジャーバンド
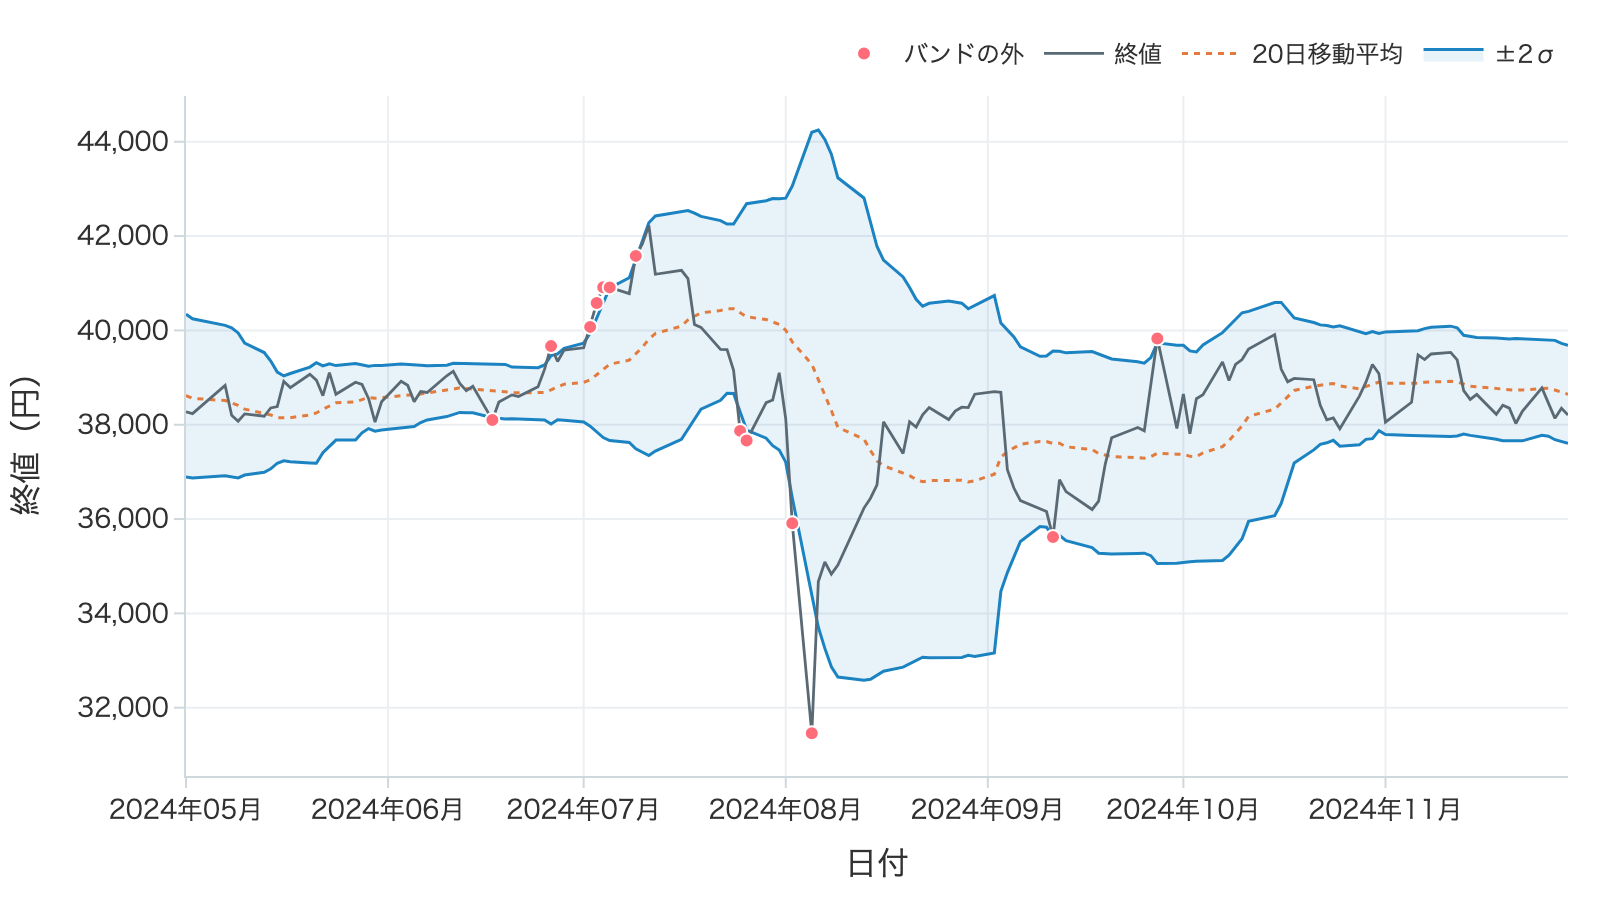
移動平均の上下に、価格のばらつき(標準偏差)に応じた幅を持たせたものです。価格の大半がこの幅に収まるという考え方で、幅を超えたときに行きすぎと判断したり、逆に勢いがあると判断したりします。
ma20 = df['終値'].rolling(20).mean()
sd20 = df['終値'].rolling(20).std()

upper = ma20 + sd20 * 2
lower = ma20 - sd20 * 2
rollingにmean()ではなくstd()をつなぐと標準偏差になります。逆張りの場合は、終値がlowerを下回ったら売られすぎと判断して買い、終値がupperを超えたら買われすぎと判断して売る、というような使い方をします。
なお、上のコードで幅を決めているのは標準偏差の2倍です。正規分布であれば、平均から標準偏差2つぶんの範囲におよそ95%が収まります。ただし価格の動きは正規分布に従わないため、この考え方がそのまま当てはまるわけではありません。
2-6. ストキャスティクス
一定期間の値幅の中で、現在の価格がどの位置にあるかを0〜100で表します。高いほど期間中の高値圏、低いほど安値圏にあることを意味します。
low_n  = df['安値'].rolling(9).min()
high_n = df['高値'].rolling(9).max()

k = (df['終値'] - low_n) / (high_n - low_n) * 100
d = k.rolling(3).mean()
この指標は終値だけでは計算できず、期間中の高値と安値が必要です。日経平均のCSVには始値、高値、安値も入っているので、read_csvのusecolsを広げれば読み込めます。
k(%K)をさらに移動平均したd(%D)と組み合わせて使うのが一般的です。ここでも、指標から別の指標を作っています。
rolling、diff、clip、標準偏差の関連問題
3. 売買手法とバックテスト
3-1. ゴールデンクロスとデッドクロス
2章で計算した指標は、それだけでは売買の判断になりません。指標をもとに「どうなったら買うか」「どうなったら売るか」を決める必要があります。
最も定番といえるのが、期間の違う2本の移動平均を使う方法です。短期の線が長期の線を下から上に抜けたときをゴールデンクロス(GC)と呼び、買いのタイミングとされます。逆に上から下に抜けたときがデッドクロス(DC)で、売りのタイミングとされます。
short = df['終値'].rolling(5).mean()
long  = df['終値'].rolling(25).mean()

above = short > long   # 短期が上
below = short < long   # 短期が下

gc = above & below.shift(1, fill_value=False)   # 前日は下、今日は上
dc = below & above.shift(1, fill_value=False)   # 前日は上、今日は下
aboveは「短期が長期より上か」、belowは「短期が長期より下か」を日ごとに表したものです。それぞれの日にTrueかFalseが並びます。
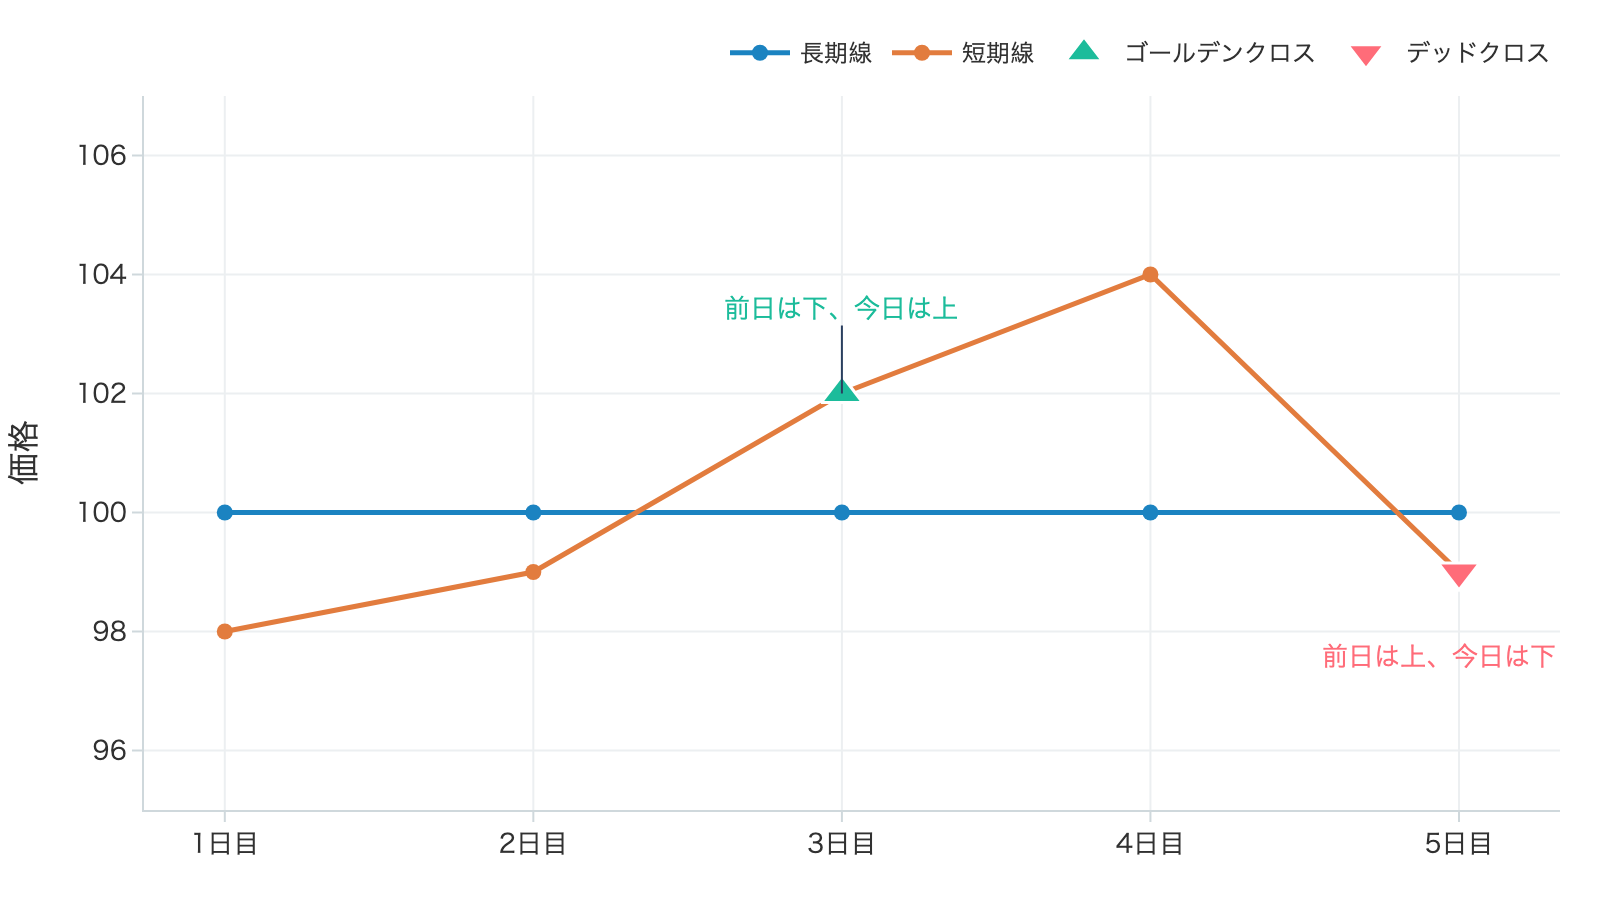
shift(1)は1日ずらすメソッドで、その日の行に前日の値を並べる働きをします。つまりbelow.shift(1)は「前日は下だったか」を表します。短期線が98、99、102、104、99と動き、長期線が100で一定だった場合を例にすると、次のようになります。
| 短期 | 長期 | above | below | below .shift(1) | gc |
|---|---|---|---|---|---|
| 98 | 100 | False | True | False | False |
| 99 | 100 | False | True | True | False |
| 102 | 100 | True | False | True | True |
| 104 | 100 | True | False | False | False |
| 99 | 100 | False | True | False | False |
ゴールデンクロスが成立したのは3日目だけです。aboveとbelow.shift(1)が両方ともTrue、つまり「前日は下、今日は上」だった日です。
4日目に注目してください。短期線は長期線を上回ったままですが、前日も上だったためbelow.shift(1)がFalseになり、gcは成立しません。抜けた瞬間の1日だけを捉えていることが分かります。
デッドクロスはこの逆で、belowとabove.shift(1)の両方がTrueである日です。この例では5日目が該当します。
fill_value=Falseは、ずらしたときに空いてしまう最初の1日をFalseで埋める指定です。前日のデータが無い日は、クロスしたとは判定しません。
2つの条件を「かつ」でつなぐのに&を使っています。andではなく&なのは、Seriesを要素ごとに比べるためです。andは1つの真偽値を対象にする構文なので、複数の要素を持つSeriesに使うとValueErrorになります。「または」は|です。
クロスの判定に前日が必要なのは、抜けた瞬間を捉えたいからです。単にshort > longとすると、上回っている間ずっと条件が成立してしまいます。
3-2. バックテストとは
売買のルールが決まったら、それが過去に通用したかを確かめます。バックテストとは、決めたルールを過去のデータに当てはめて、その期間にどのような成績になったかを確認することです。
やることは単純で、データを古い日から順に見ていき、買いの条件が成立したら「買った」と記録し、売りの条件が成立したら「売った」と記録して損益を計算します。注文を出すわけではないので、必要なのは過去の価格データと計算だけです。
一方で、結果の読み方には注意が必要です。バックテストで良い成績が出たとしても、それはその期間にそのルールが合っていたということであって、将来も同じようになるとは限りません。機械学習と同じように、過学習の可能性があることを考慮する必要があります。
shift、過学習の関連問題
4. 事前準備
4-1. ライブラリをインストール
pandasとPlotlyを使います。
pip install pandas plotly
4-2. 日経平均のデータを用意
日経平均のデータは次のサイトでダウンロードできます。
ページ内の「日経平均株価 日次データ」から、nikkei_stock_average_daily_jp.csvをダウンロードします。
CSVファイルの中身は次のようになっています。文字コードはcp932(Shift_JIS)で、最終行には注意書きが入っています。ダウンロードした時期によってデータの内容は変わるため、この記事に載せている数字とは違う結果になることがあります。
データ日付,終値,始値,高値,安値
"2023/01/04","25716.86","25834.93","25840.68","25661.89"
"2023/01/05","25820.80","25825.50","25947.10","25750.46"
 ...
"2026/09/11","64011.34","64276.82","64312.02","63208.63"
"本資料は日経の著作物であり、本資料の全部又は一部を、いかなる形式によっても日経に無断で複写、複製、転載または流布することができません。"
次に、5章のコードをコピーしてbacktest.pyという名前で保存します。ダウンロードしたnikkei_stock_average_daily_jp.csvを、そのbacktest.pyと同じフォルダに置きます。
プロジェクトフォルダ
├─ backtest.py
└─ nikkei_stock_average_daily_jp.csv
5. コード全体
import pandas as pd
import plotly.graph_objects as go

CSV_FILE = 'nikkei_stock_average_daily_jp.csv'
SHORT = 5
LONG = 25
AMOUNT = 1_000_000   # 1回の取引で投じる金額(円)


# 6-1. CSVを読み込む
def load_data(path):
    df = pd.read_csv(
        path,
        encoding='cp932',
        parse_dates=['データ日付'],
        date_format='%Y/%m/%d',
        usecols=[0, 1],
        index_col=0,
        skipfooter=1,
        engine='python',
    )
    return df


# 6-2. 売買シグナルを作る
def add_signals(df, short, long):
    short_ma = df['終値'].rolling(short).mean()
    long_ma = df['終値'].rolling(long).mean()

    above = short_ma > long_ma   # 短期が上
    below = short_ma < long_ma   # 短期が下

    return pd.DataFrame({
        '終値': df['終値'],
        '短期': short_ma,
        '長期': long_ma,
        'GC': above & below.shift(1, fill_value=False),
        'DC': below & above.shift(1, fill_value=False),
    })


def backtest(df, short, long):
    df = add_signals(df, short, long)

    # 6-3. 売買を再現する
    entry_price = None
    trades = []
    total = 0

    for date, row in df.iterrows():
        if entry_price is None:          # 持っていない
            if row['GC']:
                entry_price = row['終値']
                entry_date = date
        else:                            # 持っている
            if row['DC']:
                profit = AMOUNT * (row['終値'] / entry_price - 1)
                trades.append({'買い日': entry_date, '売り日': date, '損益': profit})
                total += profit
                entry_price = None

    # 6-4. 成績を計算する
    cumulative = pd.Series([t['損益'] for t in trades]).cumsum()
    wins = [t for t in trades if t['損益'] > 0]
    return {
        '短期': short,
        '長期': long,
        '取引数': len(trades),
        '勝率': len(wins) / len(trades) * 100 if trades else 0,
        '総利益': total,
        '最大DD': (cumulative.cummax() - cumulative).max() if trades else 0,
        'trades': trades,
        'df': df,
    }


# 6-4. 成績を表示する
def show_result(result):
    print(f"取引回数 : {result['取引数']}回")
    print(f"勝率     : {result['勝率']:.0f}%")
    print(f"総利益   : {result['総利益']:+,.0f}円")
    print(f"最大DD   : -{result['最大DD']:,.0f}円")


# 6-5. グラフにする
def plot(result):
    df, trades = result['df'], result['trades']
    fig = go.Figure()
    fig.add_scatter(x=df.index, y=df['終値'], name='終値', line=dict(color='#888', width=1))
    fig.add_scatter(x=df.index, y=df['短期'], name=f"短期{result['短期']}日", line=dict(color='#E27C3E'))
    fig.add_scatter(x=df.index, y=df['長期'], name=f"長期{result['長期']}日", line=dict(color='#1B83C1'))
    buy = [t['買い日'] for t in trades]
    sell = [t['売り日'] for t in trades]
    fig.add_scatter(x=buy, y=df.loc[buy, '終値'], mode='markers', name='買い',
                    marker=dict(symbol='triangle-up', size=12, color='#1CBC9B'))
    fig.add_scatter(x=sell, y=df.loc[sell, '終値'], mode='markers', name='売り',
                    marker=dict(symbol='triangle-down', size=12, color='#FF6C79'))
    fig.update_layout(title='日経平均と売買タイミング', xaxis_title='日付', yaxis_title='終値')
    fig.write_html('chart.html', auto_open=True)


def main():
    df = load_data(CSV_FILE)
    result = backtest(df, SHORT, LONG)
    show_result(result)
    plot(result)


if __name__ == '__main__':
    main()
コピーしました
ターミナルで実行すると成績が表示され、chart.htmlが書き出されてブラウザで開きます。
python backtest.py
6. コード説明
6-1. CSVを読み込む
def load_data(path):
    df = pd.read_csv(
        path,
        encoding='cp932',
        parse_dates=['データ日付'],
        date_format='%Y/%m/%d',
        usecols=[0, 1],
        index_col=0,
        skipfooter=1,
        engine='python',
    )
    return df
read_csv関数の引数の役割は、次のとおりです。
encoding='cp932'は文字コードの指定です。指定しないと日本語の列名を読めずエラーになります。
parse_datesとdate_formatで「データ日付」列を日付として読み込みます。index_col=0でその列をインデックスにすると、日付で範囲を絞り込めるようになります。
usecols=[0, 1]は読み込む列の指定です。0が「データ日付」、1が「終値」です。backtest.pyでは終値しか使わないため、始値、高値、安値は読み込みません。
skipfooter=1は最終行を読み飛ばす指定です。CSVの最後には著作権に関する注意書きが入っており、これをデータとして読むとエラーになります。なお、skipfooterはengine='python'を指定しなくても読み込めますが、警告が表示されます。
読み込んだdfの中身は次のようになります。
| データ日付 | 終値 |
|---|---|
| 2023-01-04 | 25716.86 |
| 2023-01-05 | 25820.80 |
| 2023-01-06 | 25973.85 |
| 2023-01-10 | 26175.56 |
| 2023-01-11 | 26446.00 |
| … | … |
| 2026-09-07 | 66399.84 |
| 2026-09-08 | 65269.33 |
| 2026-09-09 | 65142.78 |
| 2026-09-10 | 65270.95 |
| 2026-09-11 | 64011.34 |
「データ日付」がインデックスになり、列は「終値」だけになっています。この場合、行数は904で、これが検証に使う営業日数です。
6-2. 売買シグナルを作る
def add_signals(df, short, long):
    short_ma = df['終値'].rolling(short).mean()
    long_ma = df['終値'].rolling(long).mean()

    above = short_ma > long_ma   # 短期が上
    below = short_ma < long_ma   # 短期が下

    return pd.DataFrame({
        '終値': df['終値'],
        '短期': short_ma,
        '長期': long_ma,
        'GC': above & below.shift(1, fill_value=False),
        'DC': below & above.shift(1, fill_value=False),
    })
3-1で書いた判定を関数にまとめたものです。終値、短期線、長期線、GC(ゴールデンクロス)、DC(デッドクロス)の5列を持つ新しいDataFrameを作って返します。これで「その日が買いのタイミングか」を行ごとに参照できます。
この時点のdfは、次のようになります。小数点以下は省略しています。
| データ日付 | 終値 | 短期 | 長期 | GC | DC |
|---|---|---|---|---|---|
| 2023-01-04 | 25716 | NaN | NaN | False | False |
| 2023-01-05 | 25820 | NaN | NaN | False | False |
| 2023-01-06 | 25973 | NaN | NaN | False | False |
| 2023-01-10 | 26175 | NaN | NaN | False | False |
| 2023-01-11 | 26446 | 26026 | NaN | False | False |
| … | … | … | … | … | … |
| 2026-09-07 | 66399 | 65235 | 66149 | False | False |
| 2026-09-08 | 65269 | 65046 | 66209 | False | False |
| 2026-09-09 | 65142 | 65209 | 66257 | False | False |
| 2026-09-10 | 65270 | 65420 | 66216 | False | False |
| 2026-09-11 | 64011 | 65218 | 66149 | False | False |
終値の右に、短期線、長期線、GC、DCの4列が増えています。先頭のほうは移動平均が計算できずNaNになっており、短期線は5日目から、長期線は25日目から値が入ります。
上に表示される範囲にはクロスした日が含まれていないため、GCとDCはすべてFalseです。実際にクロスが起きた日の前後を取り出すと、次のようになります。
| データ日付 | 終値 | 短期 | 長期 | GC | DC |
|---|---|---|---|---|---|
| 2023-04-07 | 27518 | 27855 | 27740 | False | False |
| 2023-04-10 | 27633 | 27745 | 27728 | False | False |
| 2023-04-11 | 27923 | 27672 | 27716 | False | True |
| 2023-04-12 | 28082 | 27726 | 27707 | True | False |
| 2023-04-13 | 28156 | 27863 | 27695 | False | False |
| 2023-04-14 | 28493 | 28058 | 27690 | False | False |
4月11日に短期線が長期線を下回ってDCが立ち、翌12日に上回ってGCが立っています。どちらも抜けた1日だけがTrueになり、その後はFalseに戻ることが分かります。
6-3. 売買を再現する
    entry_price = None
    trades = []
    total = 0

    for date, row in df.iterrows():
        if entry_price is None:          # 持っていない
            if row['GC']:
                entry_price = row['終値']
                entry_date = date
        else:                            # 持っている
            if row['DC']:
                profit = AMOUNT * (row['終値'] / entry_price - 1)
                trades.append({'買い日': entry_date, '売り日': date, '損益': profit})
                total += profit
                entry_price = None
iterrowsは、DataFrameを1行ずつ取り出すメソッドです。インデックスとその行の2つを返すため、for date, row in df.iterrows()と2つの変数で受け取ります。dateには「データ日付」が、rowにはその日の1行が入り、row['終値']のように列名で値を取り出せます。
ループの中は、いま持っているかどうかで二手に分かれます。持っていなければ買いのサインだけを見て、持っていれば売りのサインだけを見ます。entry_priceがNoneかどうかが、その判定です。
この形にしておくと、持っていないのに売ったり、持っているのに重ねて買ったりすることが起きません。たとえば期間の最初に現れるサインがデッドクロスだった場合、まだ何も持っていないのでelseの中に入らず、何も起きずに次の日へ進みます。
1回の取引で投じる金額は、プログラムの先頭でAMOUNTとして決めています。ここでは100万円です。利益は「投じた金額 × 値動きの割合」で求まります。たとえば買値から5%上がって売ったなら、5万円の利益です。
このコードでは、利益が出ても次の取引で投じる金額は変わりません。毎回100万円です。利益を次の取引に回していく(複利で運用する)方式もありますが、ここでは分かりやすさを優先しています。なお、持っている間に次の買いシグナルが来ることはないので、用意する資金は常に100万円だけです。
買いも売りも、判断に使うのはその日の終値です。日中に大きく下げた日でも、終値が戻していれば売りにはなりません。
6-4. 成績を計算して表示する
    cumulative = pd.Series([t['損益'] for t in trades]).cumsum()
    wins = [t for t in trades if t['損益'] > 0]
    return {
        '短期': short,
        '長期': long,
        '取引数': len(trades),
        '勝率': len(wins) / len(trades) * 100 if trades else 0,
        '総利益': total,
        '最大DD': (cumulative.cummax() - cumulative).max() if trades else 0,
        'trades': trades,
        'df': df,
    }
成績を辞書にまとめて返します。
勝率は、利益が出た取引の割合です。総利益は、各取引の損益をすべて足したものです。1回あたりの金額を固定しているので、単純な足し算になります。
cumulativeは、取引ごとの損益を古い順に足していったものです。cumsumは累積和を返すメソッドで、1回目の損益、1回目と2回目の合計、というように並びます。
cumulativeの中身は次のようになります。
| 累積損益 | |
|---|---|
| 0 | -32,830.04 |
| 1 | -37,042.02 |
| 2 | 109,205.67 |
| 3 | 93,800.24 |
| 4 | 81,707.23 |
| 5 | 69,459.03 |
| 6 | 236,439.69 |
| 7 | 217,608.50 |
| 8 | 206,557.96 |
| 9 | 200,837.54 |
| 10 | 200,370.39 |
| 11 | 153,135.74 |
| 12 | 133,037.41 |
| 13 | 101,127.62 |
| 14 | 76,987.36 |
| 15 | 41,629.98 |
| 16 | 28,963.25 |
| 17 | -34,405.19 |
| 18 | 319,883.69 |
| 19 | 288,638.54 |
| 20 | 393,452.02 |
| 21 | 596,537.63 |
| 22 | 547,524.29 |
23回ぶんの損益を順に足していった結果です。最後の547,524円が総利益と一致します。
この並びから最大DDが読み取れます。6番目で236,440円まで増えたあと、17番目で-34,405円まで減っています。この差の270,845円が最大DDです。
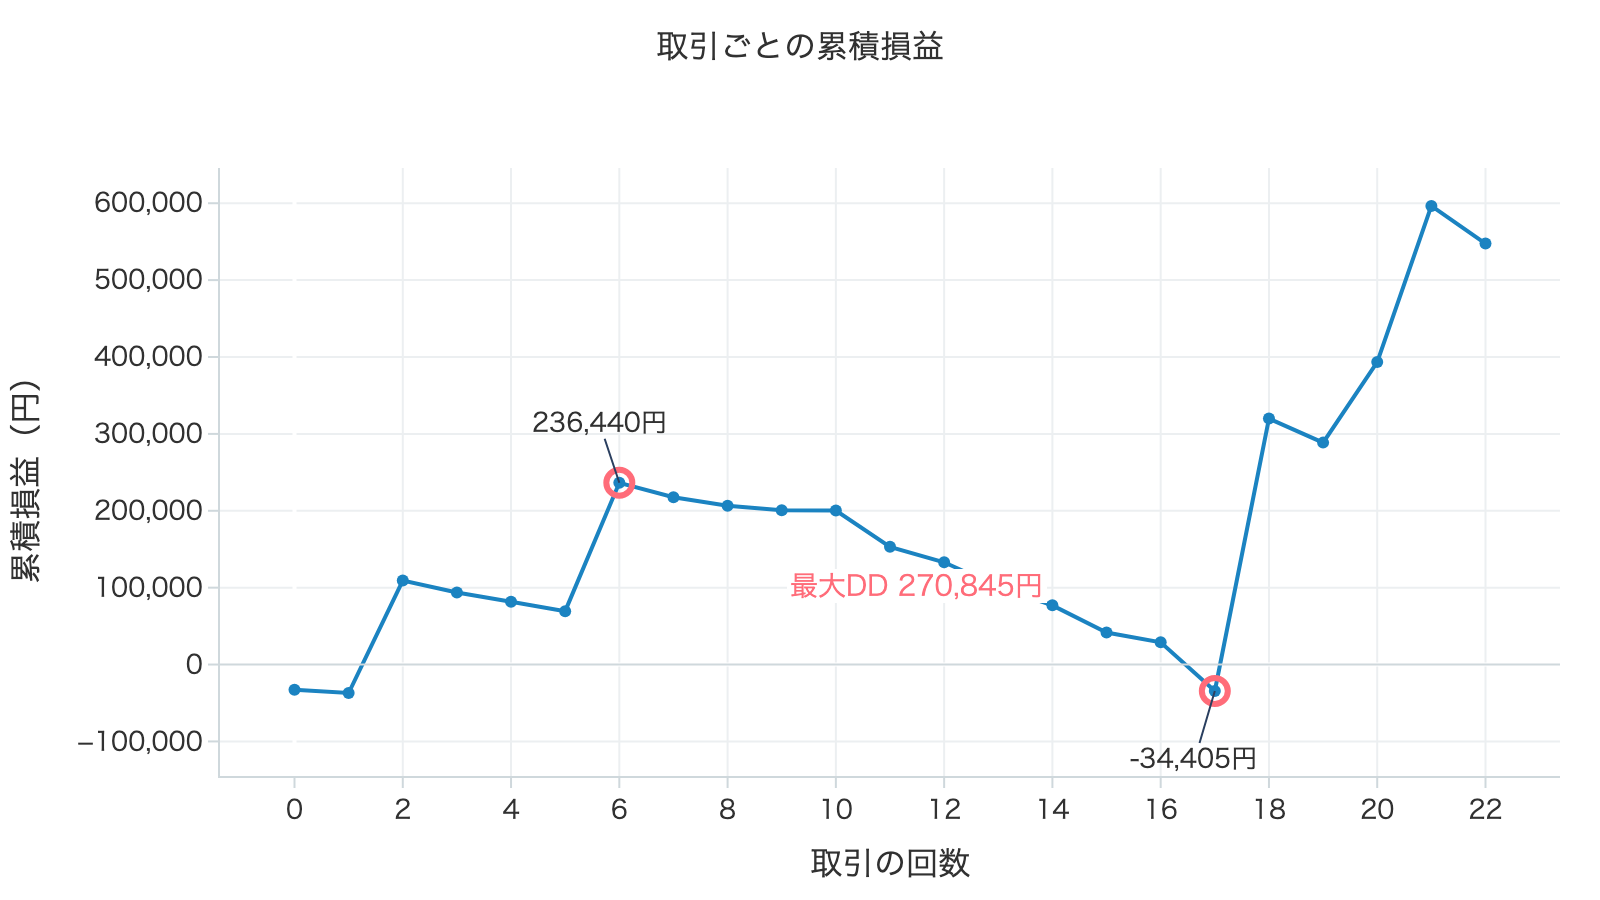
グラフにすると、増えたあとにじりじりと減り、また跳ね上がっている様子が見えます。
winsは、損益がプラスだった取引だけを取り出したリストです。[t for t in trades if t['損益'] > 0] はリスト内包表記で、「tradesから1件ずつtを取り出し、t['損益']が0より大きいものだけを集めて新しいリストにする」という意味です。winsを表の形にすると次のようになります。
| 買い日 | 売り日 | 損益 | |
|---|---|---|---|
| 0 | 2023-04-12 | 2023-07-10 | 146247.689859 |
| 1 | 2023-12-22 | 2024-03-15 | 166980.664204 |
| 2 | 2025-04-28 | 2025-11-19 | 354288.882335 |
| 3 | 2025-12-24 | 2026-03-06 | 104813.473674 |
| 4 | 2026-04-08 | 2026-07-09 | 203085.613129 |
23回のうち5回です。この件数を取引数で割ったものが勝率になります。
最大ドローダウン(最大DD)は、その累積損益が過去の最高値からどれだけ減ったかの最大値です。cummaxはそこまでの最高値を返すメソッドで、これを使うと1行で書けます。勝ち続けて増えたあとに負けが続けば、その分だけ数字が大きくなります。
なお、ここで数えているのは売買が確定した取引だけです。持っている間の含み損は入っていません。取引が0件のときはcumulativeが空になり計算できないため、if trades else 0で0を返しています。
ここで結果を辞書で返しておくと、7章でパラメーターを総当たりするときにそのまま並べ替えられます。
6-5. グラフにする
def plot(result):
    df, trades = result['df'], result['trades']
    fig = go.Figure()

    fig.add_scatter(x=df.index, y=df['終値'], name='終値', line=dict(color='#888', width=1))
    fig.add_scatter(x=df.index, y=df['短期'], name=f"短期{result['短期']}日", line=dict(color='#E27C3E'))
    fig.add_scatter(x=df.index, y=df['長期'], name=f"長期{result['長期']}日", line=dict(color='#1B83C1'))

    buy = [t['買い日'] for t in trades]
    sell = [t['売り日'] for t in trades]

    fig.add_scatter(x=buy, y=df.loc[buy, '終値'], mode='markers', name='買い',
                    marker=dict(symbol='triangle-up', size=12, color='#1CBC9B'))
    fig.add_scatter(x=sell, y=df.loc[sell, '終値'], mode='markers', name='売り',
                    marker=dict(symbol='triangle-down', size=12, color='#FF6C79'))

    fig.update_layout(title='日経平均と売買タイミング', xaxis_title='日付', yaxis_title='終値')
    fig.write_html('chart.html', auto_open=True)
goは、冒頭でimport plotly.graph_objects as goとして読み込んでいるモジュールです。go.Figure()でまだ何も描かれていない空のグラフを作り、そこにadd_scatterで線やマーカーを1つずつ重ねていきます。
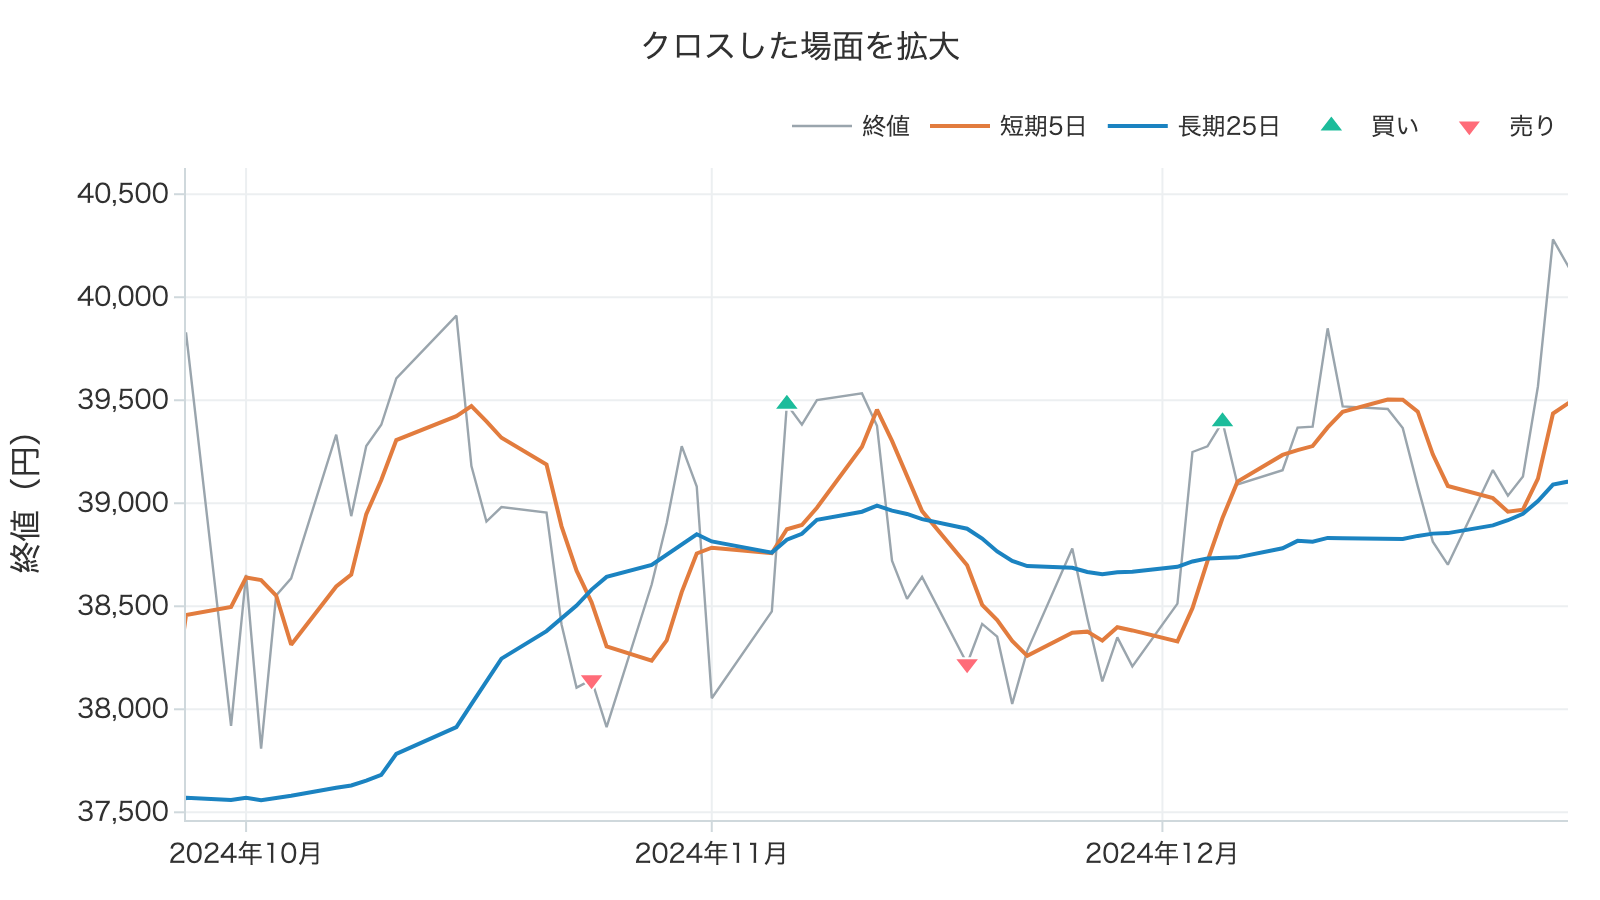
ここでは終値、短期線、長期線の3本を重ねたうえで、買いと売りのタイミングを三角のマーカーで表示します。add_scatterを5回呼んでいるのはそのためです。nameに渡した文字列が、グラフ右上の凡例に並びます。
買いと売りは、線ではなくマーカーで表示します。mode='markers'が「線を引かずマーカーだけを描く」指定で、形はmarker=dict(...)のsymbolで決めます。ここではtriangle-upとtriangle-downを指定し、買いを上向き、売りを下向きの三角にしています。位置は、x座標に売買した日付のリスト、y座標にその日の終値を渡して決めます。df.loc[buy, '終値'] のように日付のリストをそのまま渡して値を取り出せるのが、pandasの便利なところです。
add_scatterで重ね終えたら、update_layoutでグラフ全体の設定をします。titleがグラフのタイトル、xaxis_titleとyaxis_titleがそれぞれ横軸と縦軸のラベルです。update_layoutでは、このほかに背景色や凡例の位置なども指定できます。
最後にwrite_htmlでchart.htmlとして書き出します。auto_open=Trueを指定すると、書き出したあとブラウザで自動的に開きます。
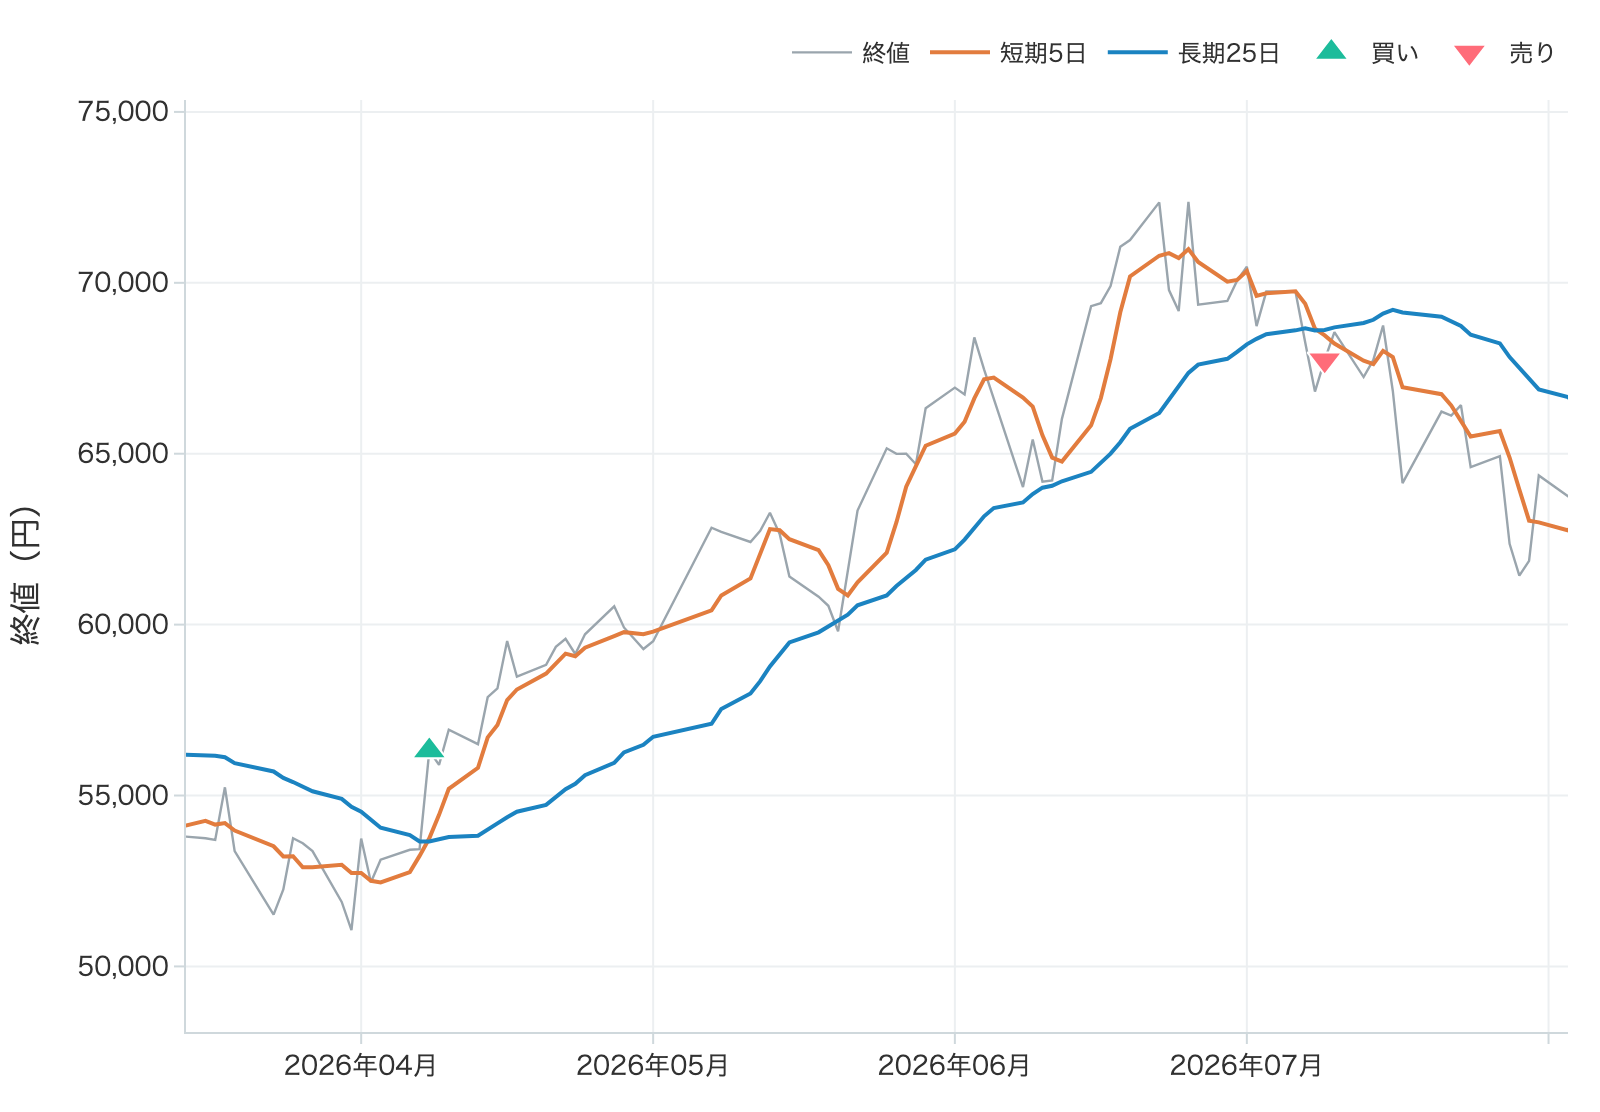
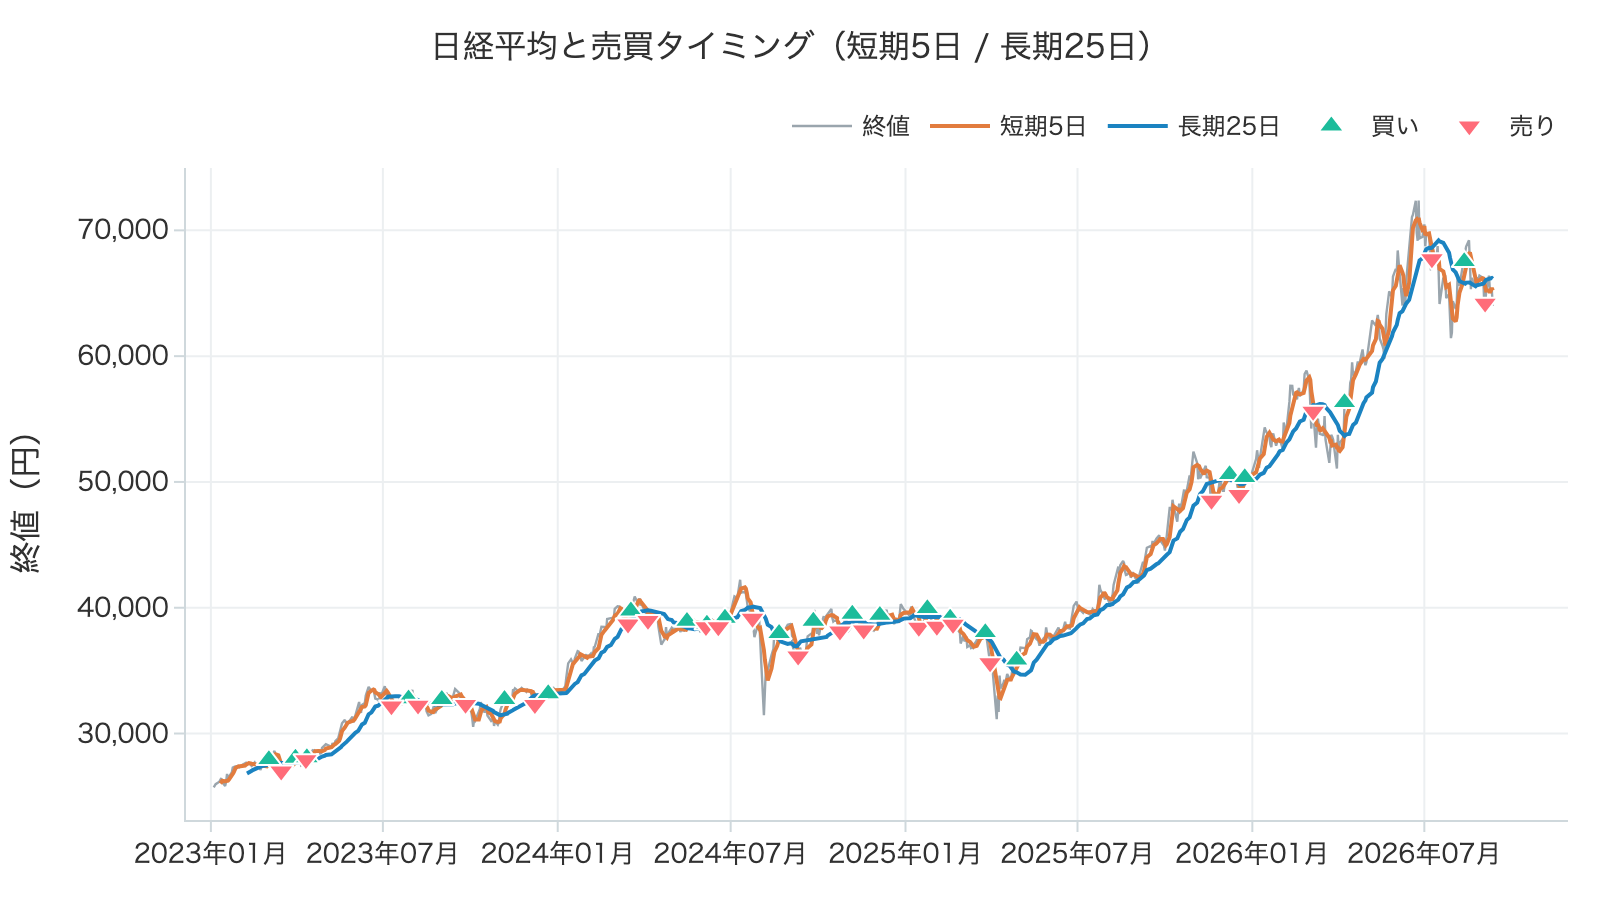
下のグラフは画像ですが、「グラフを開く」を押すとブラウザでグラフが表示されます。Plotlyのグラフはマウスで範囲を選ぶと拡大できます。クロスした場面を拡大すると、短期線と長期線が交差した日に三角が置かれていることを確認できます。範囲の拡大は、ダブルクリックで元に戻ります。
6-6. 結果を見る
移動平均のクロスを短期5日、長期25日で実行すると、次の結果になりました。期間は2023年1月4日から2026年9月11日までの904営業日です。
| 項目 | 値 |
|---|---|
| 取引回数 | 23回 |
| 勝率 | 22% |
| 総利益 | +547,524円 |
| 最大DD | -270,845円 |
1回100万円の取引を23回行って、合計で55万円ほどの利益が出ました。ただ、勝率が22%という数字が気になります。23回のうち利益が出たのは5回だけで、18回は損失です。それなのになぜ利益が残ったのでしょうか。
取引ごとの損益を集計すると理由が分かります。
| 回数 | 合計 | 平均 | 最大 | |
|---|---|---|---|---|
| 勝ち | 5回 | +975,416円 | +195,083円 | +354,289円 |
| 負け | 18回 | -427,892円 | -23,772円 | -63,368円 |
勝った5回で97万円を稼ぎ、負けた18回で43万円を失っています。1回あたりで見ると、利益が出たときの平均は+195,083円、損失のときの平均は-23,772円で、その差は約8倍あります。小さく何度も負けて、たまに大きく勝つという形です。
これは移動平均を使った手法の性質によるものです。価格が上下を繰り返す局面ではクロスが頻発し、そのたびに小さな損失が出ます。一方、価格が一方向に動き続ける局面では長く持ち続けることになり、大きな利益になります。
勝率が高い=成績が良い、とは限らないことが分かります。
read_csv、iterrows、cumsum、scatterの関連問題
7. パラメーターを変えてみる
ここまで短期5日、長期25日で計算してきましたが、この2つの数字に根拠があるわけではありません。定番としてよく使われるというだけです。
backtestを関数にしてあるので、期間を変えて何度も呼ぶことができます。短期を3〜30日、長期を10〜120日の範囲で総当たりしてみます。
df = load_data(CSV_FILE)

results = []
for short in range(3, 31):
    for long in range(10, 121, 5):
        if short >= long:
            continue
        results.append(backtest(df, short, long))

results.sort(key=lambda r: -r['総利益'])

print('短期  長期  取引数  勝率      総利益        最大DD')
for r in results[:10]:
    print(f"{r['短期']:>4}{r['長期']:>6}{r['取引数']:>7}{r['勝率']:>6.0f}%"
          f"{r['総利益']:>12,.0f}円{-r['最大DD']:>12,.0f}円")
二重ループで組み合わせを作り、結果をリストに溜めて総利益で並べ替えています。短期が長期以上になる組み合わせは意味がないのでcontinueで飛ばしています。
上位10件は次のとおりです。
| 短期 | 長期 | 取引数 | 勝率 | 総利益 | 最大DD |
|---|---|---|---|---|---|
| 12 | 100 | 3 | 67% | 853,399円 | -17,971円 |
| 16 | 20 | 27 | 63% | 829,309円 | -58,839円 |
| 29 | 80 | 4 | 75% | 819,368円 | -102,338円 |
| 14 | 30 | 16 | 50% | 815,550円 | -53,140円 |
| 28 | 85 | 5 | 40% | 802,576円 | -112,644円 |
| 30 | 80 | 4 | 50% | 799,157円 | -114,335円 |
| 8 | 105 | 5 | 40% | 797,922円 | -44,167円 |
| 27 | 80 | 4 | 50% | 797,073円 | -134,199円 |
| 9 | 95 | 6 | 67% | 793,441円 | -31,626円 |
| 15 | 20 | 26 | 62% | 786,306円 | -76,362円 |
最も良かったのは短期12日、長期100日の組み合わせで+853,399円でした。5日と25日の+547,524円と比べると1.5倍以上です。589通りのうち547通り、実に93%がプラスで終わっています。
ただし、1位の組み合わせは3年半でわずか3回しか売買していません。上位10件のうち6件が5回以下です。最大DDが17,971円と小さいのも、取引が3回しかないためです。数回の結果で、その組み合わせが優れていると言えるでしょうか。
そして最も大事な点があります。上位に並んだ組み合わせは、この期間の日経平均に最も合っていたものを589通りの中から選び出した結果にすぎません。別の期間で同じ成績になる保証はどこにもありません。
パラメーターを細かく探すほど良い数字は見つかりますが、それは手法が優れていることの証明にはならず、その期間に合わせただけということが起こります。3-2で触れた過学習です。バックテストの結果を見るときは、期間を変えても同じような成績になるかを確かめることが欠かせません。
この繰り返しをスマートフォンでできるようにしたのが、次章のアプリです。
8. スマホアプリで試す
実際に手を動かしてみると、条件を変えるたびにコードを書き換えて実行し直すのが手間でした。7章の総当たりは移動平均の期間2つだけでしたが、指標の種類を増やし、損切りや利確の条件も加えるとなると、組み合わせは一気に増えます。
そこで、スマートフォンでバックテストができるアプリを作りました。扱うのはビットコインで、日足のほかに4時間足などの短い足にも対応しています。20種類の指標と24種類の売却条件を組み合わせられるようにしています。7章の二重ループにあたる処理も入っていて、3,000通りまでの組み合わせを試せます。
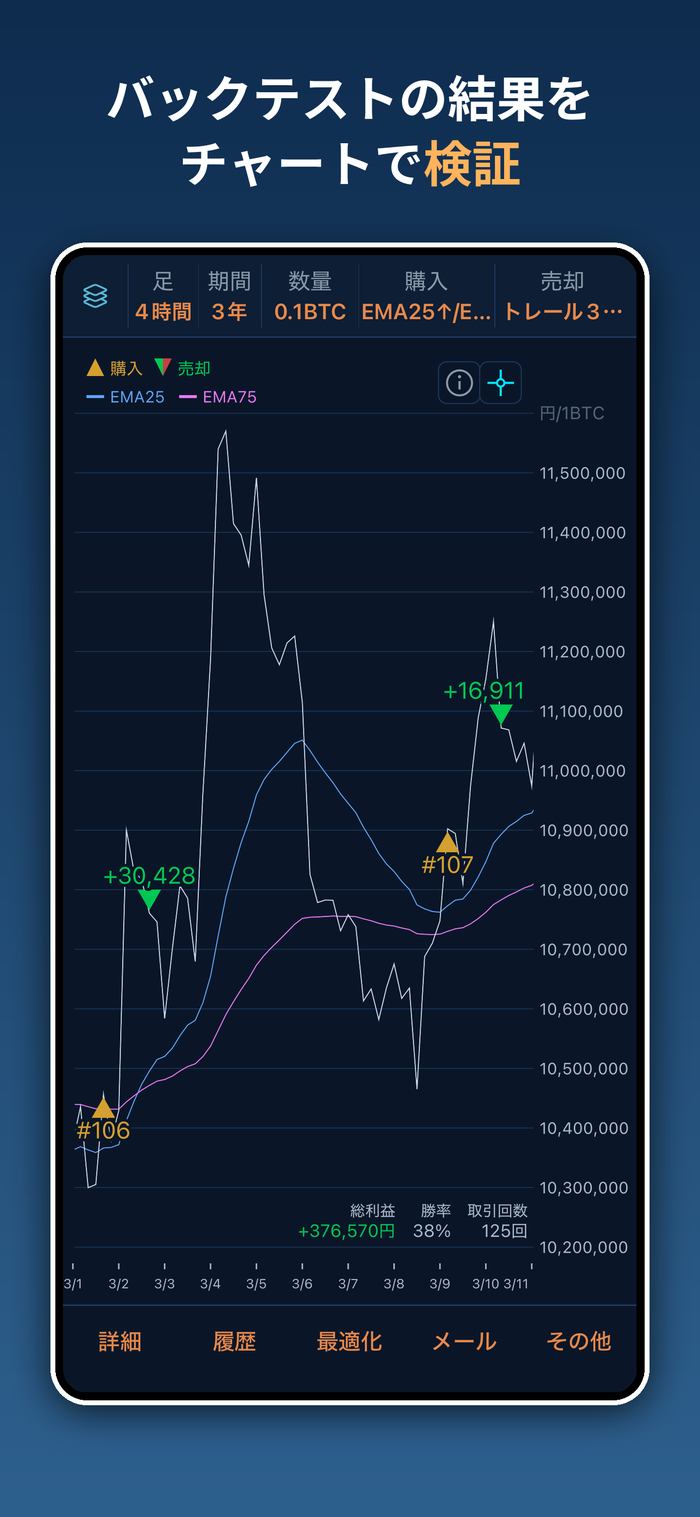
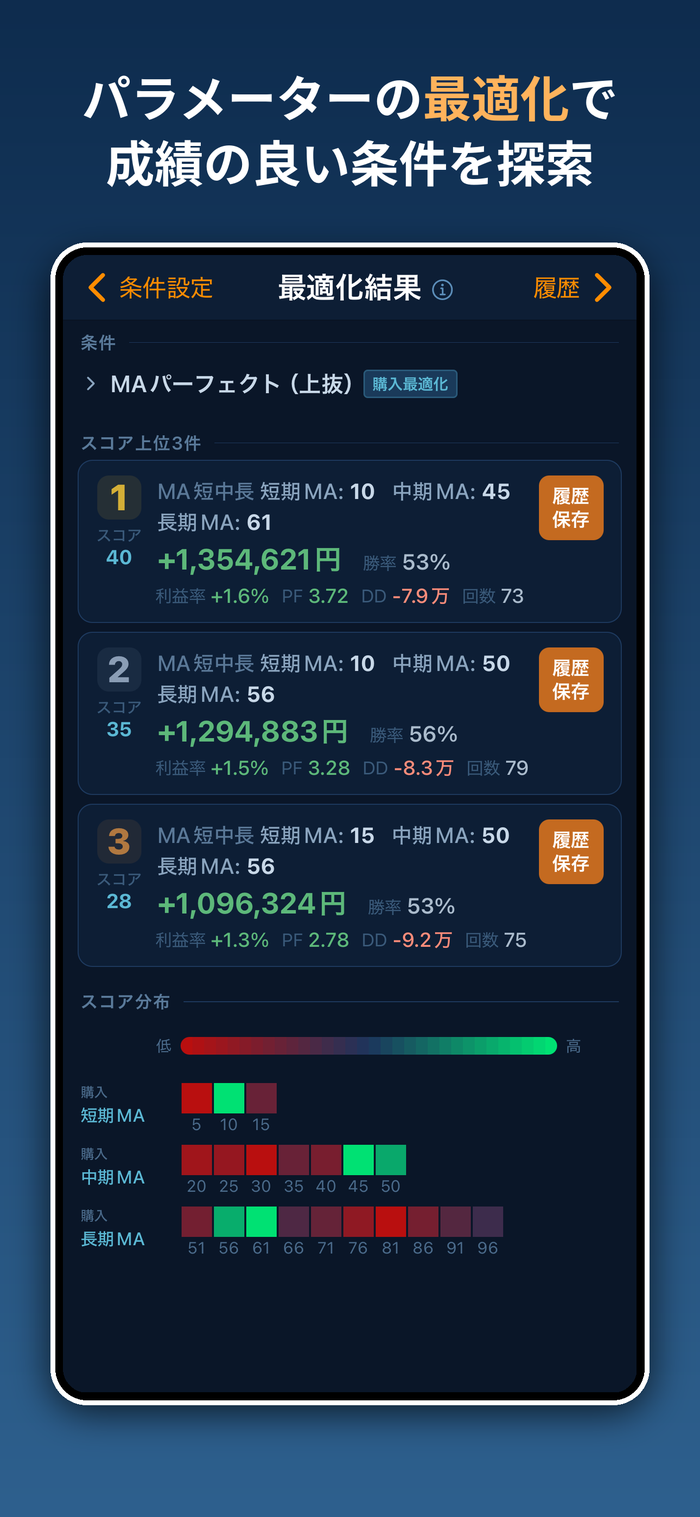
1枚目がバックテストの結果で、2枚目がパラメーターを総当たりした結果です。アプリはReact Nativeで制作しました。
iPhoneとAndroidで無料で使えます。
パソコンでご覧の場合は、次のQRコードをスマートフォンで読み取ってください。
シェア